Awaria pojedynczego serwera nie powinna zatrzymywać działalności firmy. Niestety w wielu organizacjach nadal funkcjonują krytyczne systemy oparte na pojedynczych punktach awarii. W praktyce oznacza to ryzyko przestojów, utraty dostępu do danych oraz problemów z realizacją wymagań związanych z cyberbezpieczeństwem i ciągłością działania.
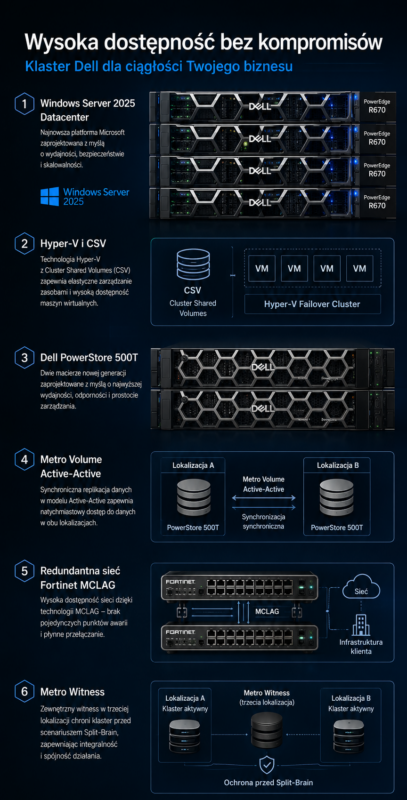
W jednym z ostatnich projektów Dimers wdrożył środowisko wysokiej dostępności dla klienta z branży infrastrukturalnej. Celem było stworzenie architektury odpornej na awarie serwerów, sieci i pamięci masowej oraz zapewnienie fundamentu pod wymagania dotyczące ciągłości działania i zarządzania ryzykiem. W środowisku wykorzystano klaster Windows Server Failover Cluster, Hyper‑V, Cluster Shared Volumes oraz redundantną warstwę storage opartą o Dell PowerStore Metro Volume.
Dlaczego wysoka dostępność stała się dziś wymaganiem biznesowym?
Nowe regulacje, takie jak NIS2 oraz krajowe przepisy dotyczące cyberbezpieczeństwa, kładą szczególny nacisk na:
ciągłość działania usług,
zarządzanie ryzykiem,
odporność operacyjną,
zdolność do minimalizowania skutków incydentów,
zapewnienie dostępności kluczowych systemów.
W praktyce oznacza to, że infrastruktura IT powinna być projektowana z założeniem występowania awarii, a nie ich braku.
Eliminacja pojedynczych punktów awarii
W ramach realizacji wdrożono architekturę opartą o:
4 serwery Dell PowerEdge R670 tworzące klaster wysokiej dostępności,
Metro Witness zabezpieczający przed scenariuszem Split‑Brain.
Dzięki takiemu podejściu awaria pojedynczego serwera, przełącznika czy kontrolera macierzy nie powoduje zatrzymania środowiska produkcyjnego. Mechanizmy klastrowe automatycznie utrzymują dostępność usług oraz maszyn wirtualnych. Microsoft wskazuje, że celem architektury Failover Clustering jest przejęcie obciążenia przez pozostałe węzły w przypadku awarii oraz utrzymanie ciągłości działania krytycznych systemów.
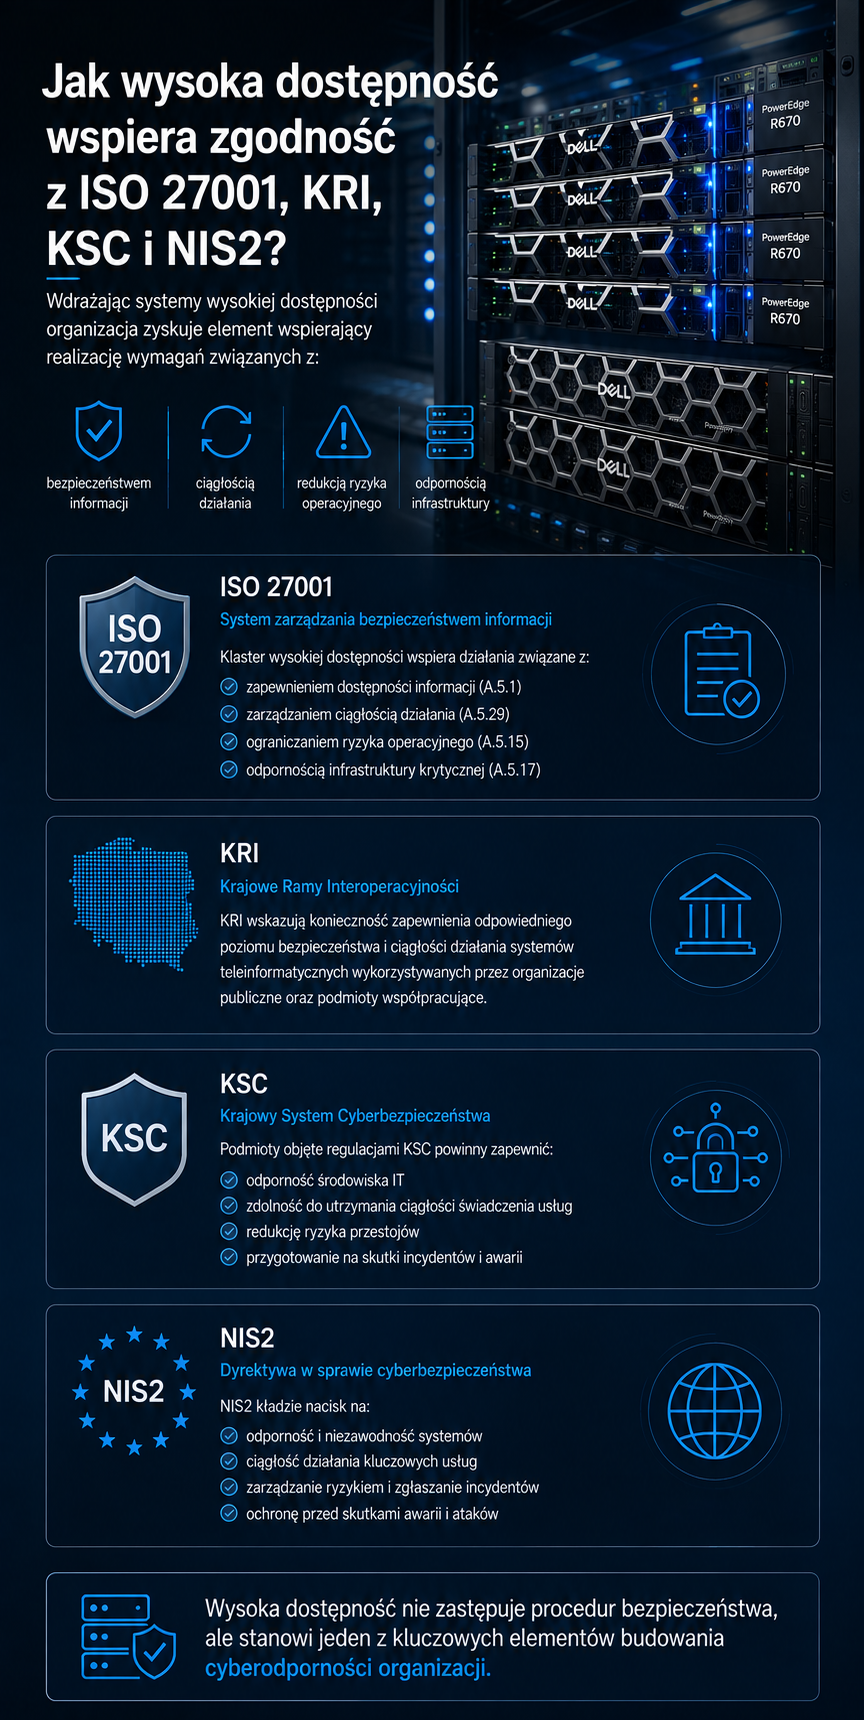
Jak wysoka dostępność wspiera zgodność z ISO 27001, KRI, KSC i NIS2?
Wdrażając systemy wysokiej dostępności organizacja zyskuje element wspierający realizację wymagań związanych z:
ISO 27001
Klaster wysokiej dostępności wspiera działania związane z:
zapewnieniem dostępności informacji,
zarządzaniem ciągłością działania,
ograniczaniem ryzyka operacyjnego,
odpornością infrastruktury krytycznej.
KRI (Krajowe Ramy Interoperacyjności)
KRI wskazują konieczność zapewnienia odpowiedniego poziomu bezpieczeństwa i ciągłości działania systemów teleinformatycznych wykorzystywanych przez organizacje publiczne oraz podmioty współpracujące.
KSC i NIS2
Podmioty objęte regulacjami dotyczącymi cyberbezpieczeństwa coraz częściej analizują:
odporność środowiska IT,
zdolność do utrzymania ciągłości świadczenia usług,
redukcję ryzyka przestojów,
przygotowanie na skutki incydentów i awarii.
Wysoka dostępność nie zastępuje procedur bezpieczeństwa, ale stanowi jeden z kluczowych elementów budowania cyberodporności organizacji.
Potwierdzona wydajność środowiska
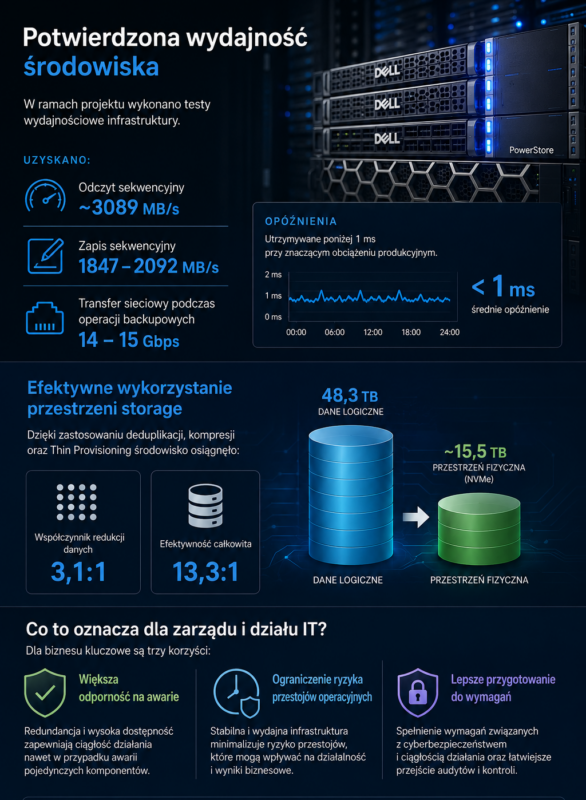
W ramach projektu wykonano testy wydajnościowe infrastruktury.
Uzyskano:
odczyt sekwencyjny około 3089 MB/s,
zapis sekwencyjny od 1847 MB/s do 2092 MB/s,
transfer sieciowy na poziomie 14-15 Gbps podczas operacji backupowych.
Analiza eksploatacyjna środowiska wykazała również utrzymywanie opóźnień poniżej 1 ms przy znaczącym obciążeniu produkcyjnym.
Efektywne wykorzystanie przestrzeni storage
Dzięki zastosowaniu deduplikacji, kompresji oraz Thin Provisioning środowisko osiągnęło współczynnik redukcji danych 3,1:1 oraz efektywność całkowitą na poziomie 13,3:1. Według dokumentacji projektowej 48,3 TB danych logicznych zajmowało fizycznie około 15,5 TB przestrzeni NVMe.
Co to oznacza dla zarządu i działu IT?
Dla biznesu kluczowe są trzy korzyści:
większa odporność na awarie,
ograniczenie ryzyka przestojów operacyjnych,
lepsze przygotowanie organizacji do wymagań związanych z cyberbezpieczeństwem i ciągłością działania.
W praktyce infrastruktura IT staje się nie tylko wydajniejsza, ale również bardziej przewidywalna i łatwiej wpisuje się w wymagania audytowe oraz procesy zarządzania ryzykiem.
Utrzymanie: outsourcing IT i monitoring 24/7
Po zakończeniu wdrożenia klient przeszedł do etapu utrzymania środowiska, obejmującego:
outsourcing IT,
opiekę informatyczną firmy,
monitoring 24/7 maszyn fizycznych i wirtualnych,
infrastrukturę zlokalizowaną w profesjonalnym Data Center.
Obsługujemy pliki cookies. Jeśli uważasz, że to jest ok, po prostu kliknij "Akceptuj wszystko". Możesz też wybrać, jakie chcesz ciasteczka, klikając "Ustawienia".
Przeczytaj naszą politykę cookie